🌱 서론
[주제 소개]: vLLM로 gpt-oss-120b 같은 큰 모델을 하나 띄워두고, 여러 클라이언트가 동시에 붙는 서비스형 LLM을 만들려면 무엇을 어디까지 직접 관리해야 하는지부터 정리해야 합니다. 초보가 가장 많이 헷갈리는 부분은 세션 메모리, 컨텍스트, KV cache, 동시 요청 수를 전부 같은 것으로 보는 순간입니다.
[왜 작성하였는가?]: 이 글은 “vLLM이 뭘 해주고, 내가 앱에서 뭘 해야 하는지”를 아주 쉽게 나누어 설명하려고 썼습니다. 읽고 나면 최소한 내가 KV cache를 직접 사용자별로 붙잡아야 하나?, max-num-seqs는 유저 수인가?, 채팅 비서와 서비스 API를 한 서버에 같이 태워도 되나? 같은 질문에 스스로 답할 수 있게 됩니다.
🧩 vLLM 오케스트레이션: 핵심 개념 파헤치기
[추론 서버]: vLLM은 기본적으로 “메시지를 받아서 답을 생성하는 엔진”입니다. OpenAI 호환 Chat Completions와 Responses API를 제공합니다.
왜 중요한가요: 엔진은 “답 생성”에 집중하고, 사용자별 기억 관리까지 자동으로 해주는 제품이 아닙니다. 서비스 설계의 출발점이 여기입니다.
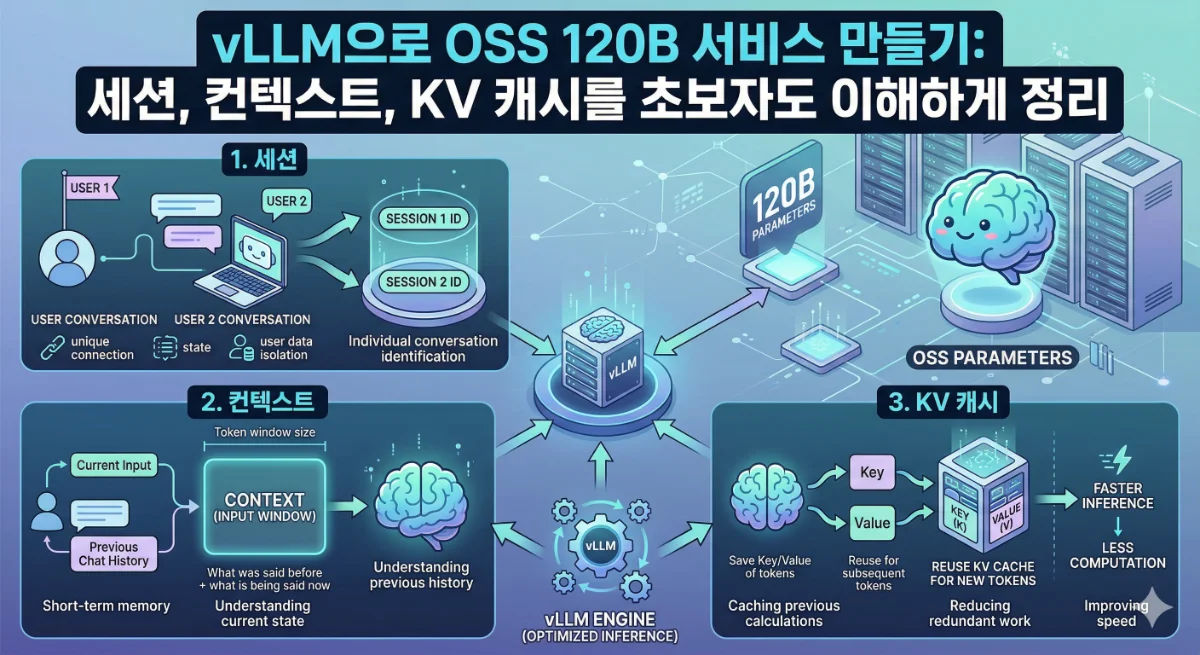
[세션 메모리]: 사용자 A의 최근 대화 20개, 사용자 B의 최근 대화 10개처럼 앱이 들고 있는 대화 기록입니다.
놓치기 쉬운 점: 이건 vLLM 내부 기능이 아니라 보통 앱 서버나 Redis/DB가 관리합니다.
이 부분은 공식 문서 기반 실무적 추론입니다: vLLM 문서는 매 요청에 messages를 보내는 OpenAI 호환 API를 설명하지만, 사용자별 대화 기억 저장소를 내장 기능으로 설명하지는 않습니다.
[KV Cache]: 모델이 토큰을 빨리 이어 말하도록 GPU에 쌓아두는 내부 캐시입니다.
실무 적용 시 고려사항: 이건 앱이 “사용자별로 수동 관리”하는 대상이 아니라, vLLM이 내부적으로 잡고 재사용/스케줄링하는 성능 자원입니다.
[컨텍스트 길이]: 한 번의 요청에서 모델이 볼 수 있는 총 길이입니다. 프롬프트 + 출력 합계가 max-model-len 안에 들어가야 합니다.
놓치기 쉬운 점: “세션이 길다”와 “한 요청 컨텍스트가 길다”는 다른 문제입니다.
[오케스트레이션]: 어떤 요청은 비서 말투로 답하고, 어떤 요청은 코드 워커로 보내고, 어떤 요청은 툴 호출을 거친 뒤 다시 요약하는 식의 상위 제어 로직입니다.
왜 중요한가요: 실제 서비스 품질은 모델 하나보다 오케스트레이션 구조에서 더 많이 갈립니다.
📘 vLLM 오케스트레이션: 공식 가이드라인 & 권장 사항
[공식 소스]:
[주요 권장 사항]:
vLLM Chat API는 모델에 chat template가 있어야 제대로 동작합니다. 없으면 --chat-template를 직접 넣어야 합니다.
vLLM은 기본적으로 Hugging Face의 generation_config.json을 적용할 수 있어서, 샘플링 값이 네 예상과 다를 수 있습니다. 서비스 일관성이 중요하면 --generation-config vllm을 검토하세요.
--gpu-memory-utilization은 GPU 메모리를 얼마나 선점할지 정하는 값입니다. 기본값은 0.9입니다.
--kv-cache-memory-bytes를 지정하면 gpu_memory_utilization 대신 KV cache 크기를 바이트 단위로 직접 정할 수 있습니다.
--max-num-seqs는 “동시에 기억할 유저 수”가 아니라, 한 iteration에서 처리할 최대 sequence 수입니다.
vLLM은 scheduling-policy로 fcfs 또는 priority를 지원합니다.
parallel_tool_calls=false로 두면 요청당 툴 호출을 0개 또는 1개로 제한할 수 있습니다.
X-Request-Id 헤더를 켜면 요청 추적이 쉬워집니다.
안전 제일 원칙: 세션 메모리와 KV cache를 같은 것으로 보면 설계가 꼬입니다. 전자는 네 앱이 관리하고, 후자는 엔진이 관리합니다.
성능 및 효율성: 초반에는 gpu_memory_utilization, max-model-len, max-num-seqs를 크게 잡지 말고, 실제 트래픽을 보며 키우는 편이 안전합니다.
🛠️ vLLM 오케스트레이션: 실무 적용 마스터 플랜
역할을 두 층으로 나눈다무엇을 하는가? vLLM과 앱 서버의 책임을 분리합니다.
어떻게 하는가?
vLLM: 답 생성 전용
앱 서버: 세션 기록, 프로필 선택, 컨텍스트 정리, 툴 호출, 재시도
성공 점검 vLLM은 stateless하게 답만 만들고, 사용자별 기억은 앱에서만 보입니다.
실수 방지 팁 “사용자별 KV cache를 내가 관리해야 하나?”라는 생각은 버리세요. 그건 보통 앱 레벨 책임이 아닙니다.
세션 구조를 먼저 정한다무엇을 하는가? 클라이언트별 최근 대화와 요약 메모를 저장할 구조를 만듭니다.
어떻게 하는가?
{
  "session_id": "user-123",
  "profile": "assistant",
  "recent_messages": ["최근 대화 N개"],
  "summary_memory": "오래된 대화 요약"
}
성공 점검 사용자 A와 B의 대화가 섞이지 않고, 오래된 대화도 요약 형태로 남습니다.
실수 방지 팁 모든 히스토리를 매번 통째로 보내면 컨텍스트와 비용이 같이 폭증합니다.
vLLM 메모리와 동시성은 보수적으로 시작한다무엇을 하는가? 큰 모델을 무리 없이 띄우고, 서비스용 최소 동시성만 확보합니다.
어떻게 하는가?
# Before
--gpu-memory-utilization 0.75
--max-model-len 8192
--max-num-seqs 8

# After (초기 운영 예시)
--gpu-memory-utilization 0.60
--max-model-len 8192
--max-num-seqs 4
무엇이 어떻게 변했는지 요약: 메모리 선점을 줄이고, 동시 처리 수를 욕심내지 않게 시작합니다.
성공 점검 모델이 안정적으로 뜨고, idle VRAM이 덜 과해집니다.
실수 방지 팁 max-num-seqs를 크게 잡는다고 곧바로 “유저를 많이 받을 수 있는 서비스”가 되는 건 아닙니다.
컨텍스트는 최근 대화 + 요약 메모로 나눠 보낸다무엇을 하는가? 긴 세션을 짧은 컨텍스트로 압축합니다.
어떻게 하는가?
system prompt
+ summary_memory
+ recent_messages(최근 10~20개)
+ current user message
성공 점검 오래 대화한 사용자도 답변 품질이 무너지지 않고, 요청 길이가 통제됩니다.
실수 방지 팁 “컨텍스트 유지”는 대화 전부를 넣는 게 아니라, 오래된 내용은 요약하고 최근 내용만 원문으로 주는 방식이 기본입니다.
프로필을 분리해 같은 모델을 여러 용도로 쓴다무엇을 하는가? 같은 gpt-oss-120b라도 비서/코드/요약 용도별로 정책을 분리합니다.
어떻게 하는가?
assistant: 짧고 자연스러운 대화
coder: 낮은 temperature, 더 긴 출력 허용
summarizer: 짧고 결정적인 요약
성공 점검 같은 모델이지만 역할에 따라 말투와 출력 길이가 달라집니다.
실수 방지 팁 “용도별로 꼭 다른 모델이어야 한다”는 생각은 초기에 과합니다. 프로필 분리부터 하세요.
추적과 장애 대응을 붙인다무엇을 하는가? 요청이 섞이거나 느려질 때 원인을 찾을 수 있게 만듭니다.
어떻게 하는가? X-Request-Id, session_id, 응답 시간, queue 길이, 실패율을 같이 기록합니다.
성공 점검 “어느 클라이언트 요청이 느렸는지”, “어떤 프로필에서 실패했는지”를 로그로 찾을 수 있습니다.
실수 방지 팁 다중 클라이언트 서비스에서 로그 없는 튜닝은 거의 감으로 싸우는 수준입니다.
📊 vLLM 오케스트레이션: 생생한 성공 & 실패 사례 분석
[성공 사례: 세션은 앱이, 추론은 vLLM이 맡은 구조]
배경: 여러 클라이언트가 붙는 챗 서비스에서 개인 비서 톤과 작업용 답변을 함께 제공해야 했습니다.
적용 전략: session_id별 최근 대화와 요약 메모는 Redis에 저장하고, vLLM은 OpenAI 호환 API로만 호출했습니다. 프로필별 system prompt도 분리했습니다.
핵심 결과: 모델은 하나였지만, 사용자별 문맥이 안정적으로 유지됐고, 동시 요청도 처리할 수 있었습니다.
성공 요인 분석: 기억 관리와 답 생성을 억지로 한 계층에 묶지 않은 점이 핵심이었습니다.
[실패 사례: KV cache와 세션 메모리를 혼동한 설계]
배경: 초반 운영자가 “유저별로 KV cache를 따로 관리해야 문맥이 유지된다”고 생각하고 설계를 시작했습니다.
실패 요인: max-num-seqs, gpu-memory-utilization, 컨텍스트 길이를 모두 크게 잡았고, 정작 앱 레벨 세션 저장은 허술했습니다.
얻은 교훈: 문맥 유지 실패의 원인은 KV cache 부족이 아니라 세션 구조 부재였습니다. KV cache는 성능 자원이고, 사용자 기억은 앱 데이터라는 점을 분리하고 나서야 구조가 단순해졌습니다.
❓ 자주 묻는 질문(FAQ)
Q1. vLLM이 사용자별 대화 기억을 자동으로 저장해주나요?
A1. 보통 아닙니다. 공식 문서는 OpenAI 호환 요청/응답을 설명하며, 사용자별 메모리 저장소를 내장 기능으로 설명하지 않습니다. 실무에선 앱이 session_id별 히스토리를 관리합니다.
Q2. KV cache랑 채팅 히스토리는 같은 건가요?
A2. 아닙니다. 채팅 히스토리는 네 앱이 들고 있는 데이터이고, KV cache는 vLLM이 GPU에서 쓰는 내부 성능 캐시입니다.
Q3. max-num-seqs를 100으로 올리면 100명의 유저를 기억하나요?
A3. 아닙니다. 그건 한 iteration에서 처리할 최대 sequence 수에 가깝습니다. 유저 기억은 세션 저장 구조가 담당합니다.
Q4. gpu-memory-utilization과 kv-cache-memory-bytes는 뭐가 다른가요?
A4. 전자는 GPU 메모리 비율로 넓게 잡는 값이고, 후자는 KV cache 크기를 바이트 단위로 직접 고정하는 값입니다.
Q5. 여러 클라이언트를 받을 거면 무조건 vLLM이 맞나요?
A5. 다중 요청과 서비스형 API에는 대체로 vLLM이 더 잘 맞습니다. 다만 단일 GPU면 초반 세팅을 보수적으로 잡아야 합니다.
Q6. 채팅 비서와 코드 워커를 같은 모델 하나로 돌려도 되나요?
A6. 됩니다. 초반엔 모델을 여러 개 나누기보다 profile과 system prompt를 나누는 편이 단순합니다.
Q7. 답변이 내 예상과 다르게 샘플링되는 이유는 뭔가요?
A7. vLLM은 기본적으로 모델 저장소의 generation_config.json을 적용할 수 있습니다. 서비스 일관성이 중요하면 그 동작을 확인하세요.
Q8. 툴 호출이 여러 개 튀어나오는 걸 막을 수 있나요?
A8. 네. vLLM 문서상 parallel_tool_calls=false면 요청당 0개 또는 1개의 툴 호출만 허용하도록 제한할 수 있습니다.
⚠️ vLLM 오케스트레이션: 실전 운영 팁 & 주의사항
[팁 1]: 초보 기준 핵심 문장 하나만 기억하세요. 세션 기억은 앱이, KV cache는 엔진이 관리한다.
[팁 2]: 큰 모델 한 개로 여러 용도를 처리하려면, 모델을 나누기 전에 assistant / worker / summarizer 프로필부터 나누세요.
[팁 3]: 단일 GPU에서는 max-model-len, max-num-seqs, gpu-memory-utilization을 한꺼번에 크게 잡지 마세요. 셋을 동시에 키우면 바로 메모리와 지연이 꼬입니다.
[팁 4]: 오래된 대화는 요약하고 최근 대화만 원문으로 보내세요. 이게 초보자가 할 수 있는 가장 현실적인 “컨텍스트 유지” 최적화입니다.
[팁 5]: X-Request-Id와 session_id를 로그에 남기면, 다중 클라이언트 서비스에서 문제 추적 난이도가 크게 내려갑니다.
[팁 6]: 나중에 Ollama와 갈아끼울 가능성이 있어도, 앱 코드는 OpenAI 호환 클라이언트 인터페이스 하나로 감싸두는 편이 안전합니다. Ollama도 OpenAI 호환 엔드포인트를 제공합니다.
TIP
초보자에게 가장 쉬운 구조는 vLLM = 답 생성 서버, 앱 = 세션/프로필/요약 관리입니다.
경고
“사용자별 KV cache를 내가 다 관리해야 한다”는 생각으로 설계에 들어가면 거의 무조건 복잡도가 폭증합니다.