🚀 서론
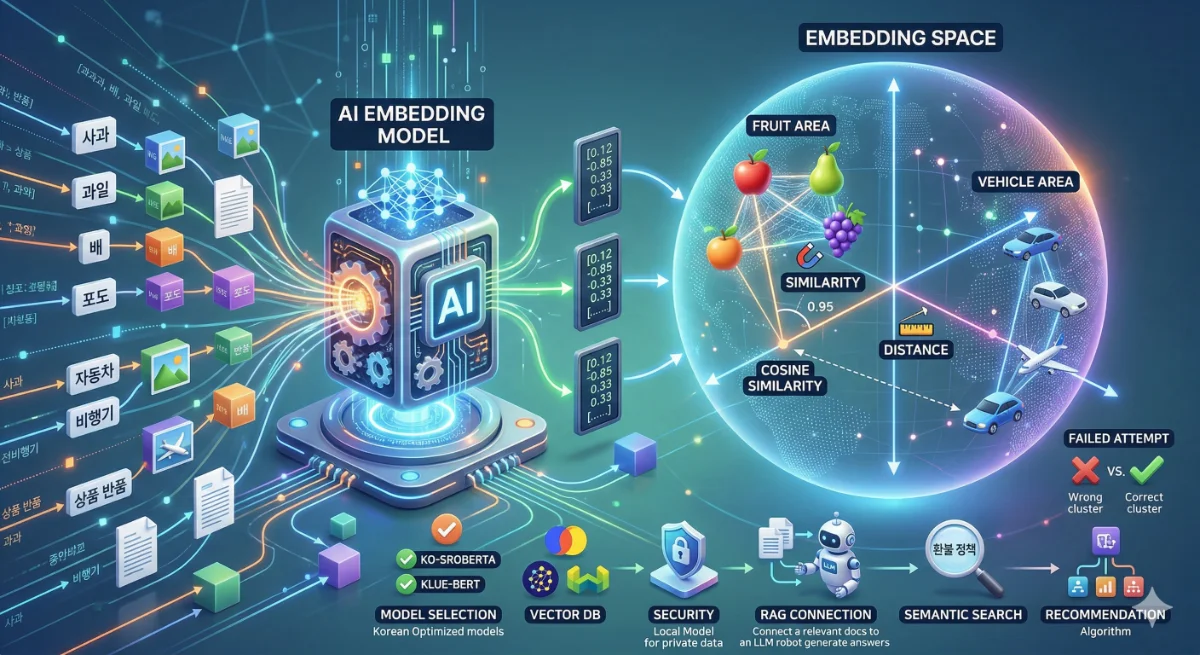
[주제 소개]: 여러분, 챗GPT나 AI 검색 서비스를 쓰다 보면 "임베딩(Embedding)"이라는 단어를 한 번쯤 들어보셨을 겁니다. 임베딩은 단어·문장·이미지 같은 복잡한 데이터를 컴퓨터가 이해할 수 있는 숫자 배열(벡터)로 변환하는 기술입니다. AI가 "사과"와 "과일"이 비슷하다는 걸 "아는" 이유, 챗봇이 내 질문의 맥락을 파악하는 이유—모두 임베딩 덕분입니다. 최근 RAG(검색 증강 생성), 추천 시스템, 의미 검색 등 AI 실무의 핵심 기술 대부분이 임베딩을 기반으로 작동합니다.
[왜 작성하였는가?]: AI 서비스를 운영하거나 개발하려는 분들이 임베딩을 모르면 "왜 검색 결과가 이상한가?", "왜 챗봇이 맥락을 못 잡는가?" 같은 문제를 해결하기 어렵습니다. 이 글을 통해 임베딩의 원리, 실전 적용법, 그리고 흔히 하는 실수까지 한 번에 정리할 수 있습니다.
🔑 임베딩: 핵심 개념 파헤치기
벡터(Vector): 숫자를 일렬로 나열한 배열입니다. 예를 들어 "사과"라는 단어가 [0.12, -0.85, 0.33, ...] 처럼 수백 개의 숫자로 표현됩니다.
왜 중요한가요?: 컴퓨터는 문자를 직접 이해하지 못합니다. 숫자로 변환해야만 연산이 가능하고, 단어 간의 의미적 거리도 계산할 수 있습니다.
임베딩 공간(Embedding Space): 모든 벡터가 모여 있는 다차원 공간입니다. 의미가 비슷한 단어·문장일수록 이 공간에서 서로 가깝게 위치합니다.
놓치기 쉬운 점: "차원이 높을수록 좋다"는 오해가 많습니다. 차원이 너무 높으면 계산 비용이 폭발적으로 늘고, 오히려 성능이 떨어질 수 있습니다. 이를 차원의 저주(Curse of Dimensionality) 라고 합니다.
🍎 직관적 비유: 지구본을 상상하세요. "사과", "배", "포도"는 같은 대륙(과일 영역)에 모여 있고, "자동차", "비행기"는 전혀 다른 대륙에 있습니다. 임베딩은 이런 개념 지도를 숫자로 만드는 기술입니다.
📚 임베딩: 공식 가이드라인 & 권장 사항
[공식 소스]: AWS 공식 문서, IBM 벡터 임베딩 가이드, HuggingFace MTEB 벤치마크, OpenAI Embeddings API 문서가 가장 신뢰할 수 있는 레퍼런스입니다.
[주요 권장 사항]:
모델은 목적에 맞게 선택: 문서 분류·감성 분석엔 Word2Vec/GloVe 같은 정적(Static) 임베딩, 챗봇·질의응답엔 BERT/GPT 같은 문맥(Contextual) 임베딩을 권장합니다.
한국어는 한국어 특화 모델 사용: 다국어 범용 모델보다 KLUE-BERT, KoSimCSE, KOCS 같은 한국어 특화 모델이 성능이 훨씬 우수합니다.
벡터 DB와 함께 사용: 생성된 임베딩은 Chroma, Pinecone, Weaviate, FAISS 같은 벡터 데이터베이스에 저장·검색해야 실전에서 쓸 수 있습니다.
안전 제일 원칙: 임베딩 모델을 바꾸면 기존 벡터와 새 벡터가 호환되지 않습니다. 모델 변경 시 전체 문서를 다시 임베딩해야 합니다.
성능 및 효율성: 임베딩 차원 수와 최대 토큰 수(max_tokens)를 반드시 확인하세요. 토큰이 초과되면 문서가 잘리고, 정보 손실이 발생합니다.
🛠️ 임베딩: 실무 적용 마스터 플랜
1. 1단계: 임베딩 모델 선택 및 설치
무엇을 하는가?: 내 프로젝트 목적(한국어 검색, 문서 분류 등)에 맞는 임베딩 모델을 고르고 설치합니다.
어떻게 하는가?: 로컬에서 무료로 시작하려면 sentence-transformers 라이브러리가 가장 쉽습니다.
# 라이브러리 설치
pip install sentence-transformers

# 한국어 지원 모델 다운로드 (자동)
# 모델 예시: jhgan/ko-sroberta-multitask (한국어 특화)
from sentence_transformers import SentenceTransformer

# 모델 로드 (처음엔 자동 다운로드)
model = SentenceTransformer('jhgan/ko-sroberta-multitask')

# 문장을 벡터로 변환
sentences = ["오늘 날씨가 맑습니다", "오늘은 화창한 하루입니다"]
embeddings = model.encode(sentences)

print(embeddings.shape) # (2, 768) → 2개 문장, 각 768차원 벡터
성공 점검: embeddings.shape가 (문장 수, 차원 수) 형태로 출력되면 성공입니다.
실수 방지 팁: GPU가 없어도 CPU로 실행 가능하지만, 문서가 많으면 매우 느립니다. 초반 테스트는 10~100개 문장으로만 해보세요.
2. 2단계: 문서 임베딩 생성 및 저장
import faiss
import numpy as np
from sentence_transformers import SentenceTransformer

model = SentenceTransformer('jhgan/ko-sroberta-multitask')

# Before: 원본 문서들 (텍스트)
documents = [
 "환불 정책은 구매 후 7일 이내입니다",
 "배송은 평균 2~3일 소요됩니다",
 "고객센터 운영시간은 평일 9시~18시입니다"
]

# After: 벡터로 변환 후 FAISS에 저장
doc_embeddings = model.encode(documents).astype('float32')

index = faiss.IndexFlatL2(doc_embeddings.shape [royzero.tistory](https://royzero.tistory.com/entry/embedding-basics-for-ml)) # 차원 수 기준 인덱스 생성
index.add(doc_embeddings) # 벡터 추가

print(f"저장된 벡터 수: {index.ntotal}") # 3

# 핵심 변화: 텍스트 → 숫자 벡터 → 빠른 유사도 검색 가능
성공 점검: index.ntotal이 문서 수와 일치하면 정상입니다.
실수 방지 팁: FAISS 인덱스는 메모리 상에만 존재합니다. faiss.write_index(index, "my_index.faiss")로 반드시 파일 저장하세요.
3. 3단계: 의미 기반 검색(Semantic Search) 구현
# 사용자 질문 임베딩
query = "상품을 반품하고 싶어요"
query_vector = model.encode([query]).astype('float32')

# 가장 유사한 문서 상위 2개 검색
distances, indices = index.search(query_vector, k=2)

for i, idx in enumerate(indices):
 print(f"[{i+1}위] {documents[idx]} (거리: {distances[i]:.4f})")

# 출력 예시:
# [1위] 환불 정책은 구매 후 7일 이내입니다 (거리: 0.1823)
# [2위] 고객센터 운영시간은 평일 9시~18시입니다 (거리: 1.2451)
성공 점검: "반품"이라는 단어가 없어도 "환불"과 관련된 문서가 1위로 나오면 의미 기반 검색이 성공한 것입니다.
실수 방지 팁: 거리(distance)가 낮을수록 유사한 것입니다. 코사인 유사도를 쓰면 값이 1에 가까울수록 유사하니, 방식에 따라 해석이 반대입니다. 사용 전 반드시 확인하세요.
4. 4단계: RAG(검색 증강 생성)와 연결
무엇을 하는가?: 임베딩 검색으로 찾은 관련 문서를 LLM(GPT, Claude 등)에게 컨텍스트로 전달해 정확한 답변을 생성합니다.
어떻게 하는가?: 검색된 문서를 프롬프트에 삽입합니다.
# 검색된 문서를 프롬프트 컨텍스트로 활용
retrieved_doc = documents[indices]

prompt = f"""
다음 정보를 바탕으로 고객 질문에 답변해주세요.

[참고 문서]
{retrieved_doc}

[고객 질문]
{query}

[답변]
"""
# 이 prompt를 LLM API에 전달
🎬 임베딩: 생생한 성공 & 실패 사례 분석
✅ 성공 사례: 중소 이커머스 "의미 검색" 도입으로 전환율 향상
배경: 쇼핑몰 검색창에 "따뜻한 겨울 아우터"를 검색하면 키워드 매칭으로 "겨울 아우터"만 나오고, 정작 "패딩" "오리털 점퍼" 같은 제품은 안 나오는 문제.
적용 전략: 전체 상품 설명을 한국어 임베딩 모델로 변환해 벡터 DB에 저장. 고객 검색어도 임베딩으로 변환해 의미 기반 검색(Semantic Search)으로 교체.
핵심 결과: "따뜻한", "보온", "방한" 등 다양한 표현으로 검색해도 관련 상품이 상위 노출. 검색 후 구매율(클릭-to-구매)이 개선되는 성과 달성.
성공 요인 분석: 키워드가 아닌 의미(Semantic)를 기반으로 검색하는 구조로 전환한 것이 핵심. 별도의 동의어 사전 관리가 불필요해 운영 부담도 감소.
❌ 실패 사례: 영어 임베딩 모델로 한국어 서비스 구축
배경: 스타트업 개발팀이 빠른 출시를 위해 OpenAI의 text-embedding-ada-002 모델(영어 특화)로 한국어 FAQ 검색 시스템을 구축.
실패 요인:
한국어 조사, 어미 변화(예: "배송해주세요" vs "배송 문의")를 모델이 제대로 처리 못함.
비슷한 의미의 한국어 문장인데도 유사도 점수가 낮게 나오는 오류 발생.
임베딩 모델 교체 시 기존에 저장된 수만 건의 벡터를 전부 다시 생성해야 했고, 이 비용이 예상보다 크게 발생.
얻은 교훈: 서비스 언어에 맞는 특화 임베딩 모델을 처음부터 선택해야 합니다. 나중에 바꾸면 전체 재임베딩 비용 + 운영 중단 위험이 발생합니다. 한국어라면 KoSimCSE, ko-sroberta, KOCS 같은 모델을 처음부터 선택하세요.
❓ 자주 묻는 질문(FAQ)
A1. 원-핫 인코딩은 단어 수만큼 차원이 늘어나고 의미 관계를 표현하지 못합니다. 임베딩은 학습을 통해 의미 관계를 반영한 고정된 저차원 벡터를 만들어냅니다. "왕-남자+여자=여왕"처럼 벡터 연산으로 의미 추론이 가능한 것이 임베딩의 핵심 강점입니다.
A2. 보통 768~1536 차원이 일반적입니다. 차원이 클수록 표현력은 높지만 저장 공간과 계산 비용도 증가합니다. 소규모 프로젝트는 256~384 차원의 경량 모델로 시작해도 충분합니다.
A3. 모델이 달라지면 벡터 공간 자체가 달라지므로, 기존에 저장된 모든 문서를 새 모델로 다시 임베딩(재색인)해야 합니다. 이 작업이 예상보다 큰 비용이 될 수 있으니 모델 선택은 신중하게 해야 합니다.
A4. API는 구현이 쉽고 성능이 안정적이지만 비용이 발생하고 데이터가 외부로 나갑니다. 로컬 모델(sentence-transformers)은 초기 설정이 필요하지만 비용이 0원이고 데이터 보안이 확보됩니다. 보안이 중요하거나 대용량 처리가 필요하면 로컬을 추천합니다.
A5. RAG(Retrieval-Augmented Generation)에서 "Retrieval(검색)" 단계의 핵심이 임베딩입니다. 문서를 임베딩으로 변환·저장하고, 질문도 임베딩으로 변환해 유사 문서를 찾은 뒤 LLM에게 전달하는 구조입니다.
A6. 가능합니다. CLIP 모델은 이미지와 텍스트를 같은 벡터 공간에 표현해 "고양이 사진"으로 텍스트를 검색하거나 그 반대도 가능합니다. Whisper 등으로 오디오도 임베딩할 수 있습니다.
A7. 대부분의 임베딩 모델은 최대 토큰 수(보통 512~8192 토큰) 제한이 있습니다. 긴 문서는 일정 크기로 청킹(Chunking) 해 나눈 뒤 각각 임베딩합니다. 청크 크기와 겹침(overlap) 설정이 검색 품질에 큰 영향을 줍니다.
A8. HuggingFace의 MTEB(Massive Text Embedding Benchmark) 리더보드를 참고하세요. 내 데이터와 비슷한 작업(검색, 분류, 군집)의 점수를 비교하면 모델 선택에 도움이 됩니다.
A9. sentence-transformers 라이브러리 + chromadb 조합이 가장 입문자 친화적입니다. pip install sentence-transformers chromadb 한 줄로 시작할 수 있고, 공식 문서와 예제가 풍부합니다.
A10. 가능합니다! ollama pull nomic-embed-text 또는 mxbai-embed-large 명령어로 임베딩 모델을 받고, Ollama API(/api/embeddings)를 통해 로컬에서 완전히 무료로 임베딩을 생성할 수 있습니다.
***
💡 실전 운영 팁 & 주의사항
⚠️ 개인정보가 포함된 데이터는 로컬 모델 필수: 고객 이름, 연락처, 의료 정보가 포함된 문서를 외부 API에 임베딩 요청하면 개인정보가 외부 서버로 전송됩니다. 민감 데이터는 반드시 Ollama, sentence-transformers 등 로컬 임베딩 모델을 사용하세요.