제가 이 문제를 처음 만났을 때, 솔직히 제일 먼저 든 생각은 “아, 또 방화벽이네”였습니다. SSH 설정을 조금 손보고, 포트포워딩까지 만진 직후였거든요. 그 직후부터 웹앱은 MongoDB 연결 에러를 뿜고, 백업 작업은 실패하고, 레플리카셋은 갑자기 프라이머리를 잃었습니다. 처음엔 단순히 포트가 막힌 줄 알았는데, 로그를 하나씩 따라가다 보니 진짜 원인은 전혀 다른 데 있었습니다. MongoDB 컨테이너가 살아 있는지보다, 레플리카셋이 그 컨테이너를 “자기 멤버”로 인정하느냐가 더 중요하다는 사실을 이번에 아주 뼈저리게 배웠습니다.
이번 글은 실제 운영 중 겪은 이 장애를 바탕으로, Docker 기반 MongoDB Replica Set이 SSH 설정 변경이나 포트포워딩 작업 이후 왜 갑자기 깨질 수 있는지, 그리고 어떤 순서로 확인해야 가장 빨리 복구되는지를 정리한 기록입니다. 내부 IP, 계정, 비밀번호 같은 민감정보는 모두 마스킹해서 적겠습니다.
문제는 “Mongo가 죽었나?”가 아니었습니다
처음 보인 증상은 아주 전형적이었습니다.
앱 쪽에서는 ECONNREFUSED
백업 쪽에서는 NotPrimaryOrSecondary
어떤 노드에서는 RSGhost
어떤 노드에서는 Does not have a valid replica set config
또 다른 로그에서는 Could not find self in current config
이쯤 되면 보통 사람은 두 가지 중 하나를 먼저 의심합니다.
방화벽
MongoDB 자체 장애
저도 그랬습니다. 특히 SSH, UFW, 포트포워딩을 건드린 직후였으니 더더욱 그렇게 생각하기 쉬웠고요.
그런데 확인해보니 구조는 이랬습니다.
[서버 A]
Mongo 멤버 2개 운영
예: 24xx, 24xx 포트
[서버 B]
Mongo 멤버 1개 운영
예: 27017
원래 의도는 3노드 레플리카셋이었습니다. 그런데 실제 상태를 보니,
여기서부터 감이 좀 오더라고요. 이건 단순 접속 실패가 아니라, 클러스터 멤버십 자체가 어긋난 상태였습니다.
나중에 알아보니, 원리는 아주 명확했습니다
처음엔 저도 “컨테이너가 떠 있으면 된 거 아니야?”라고 생각했습니다. 그런데 MongoDB Replica Set은 그렇게 단순하지 않더라고요.
핵심은 이겁니다.
쉽게 말하면, 레플리카셋은 각 노드에게 이렇게 묻는 셈입니다.
“너 설정에 들어 있는 그 멤버 맞아?”
그리고 그 노드가 이렇게 대답하면 끝입니다.
“아닌 것 같은데?”
이번 케이스가 딱 그랬습니다.
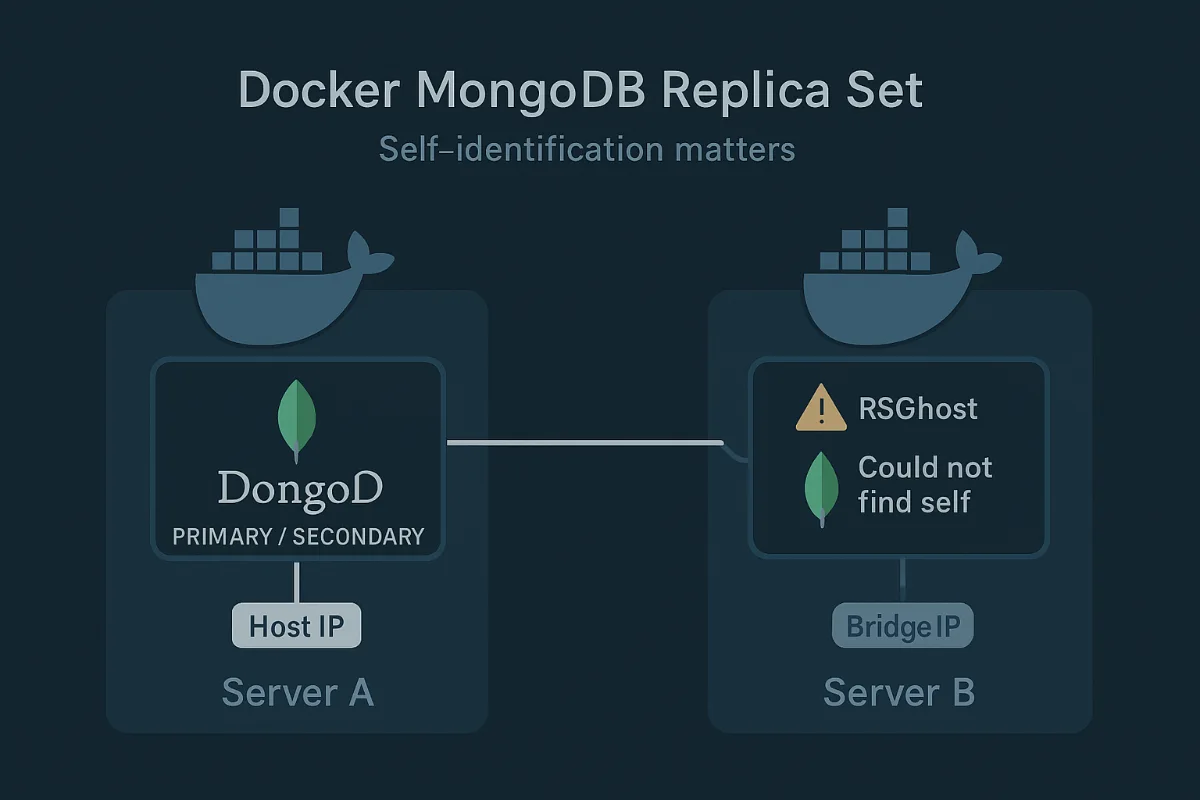
[서버 B]의 Mongo 컨테이너는 Docker bridge 네트워크 안에서 자기 자신을 내부 가상 IP로 보고 있었고, Replica Set 설정에는 그 멤버가 호스트 IP:27017로 등록돼 있었습니다. 즉:
이 둘이 안 맞으니 MongoDB는 “나는 그 멤버가 아니다”라고 판단해버린 겁니다.
처음엔 이걸 이해하는 데 시간이 좀 걸렸습니다. 왜냐하면 겉으로 보기엔 컨테이너도 떠 있고, 포트도 열려 있고, 인증도 되고, 설정도 읽히거든요. 그런데 rs.status()는 실패합니다. 이게 정말 헷갈립니다.
확인해보니, 방화벽도 일부 문제였지만 본체는 따로 있었습니다
여기서 많이들 놓치는 포인트가 있습니다. 문제가 하나만 있는 경우보다, 작은 문제가 겹쳐서 전체 장애로 커지는 경우가 훨씬 많다는 점입니다.
이번에도 그랬습니다.
1. 방화벽 문제
[서버 A] 쪽 UFW 규칙을 확인해보니, 한 멤버 포트는 열려 있었는데 다른 멤버 포트는 빠져 있었습니다. 이건 레플리카셋 입장에서 꽤 치명적입니다. “이 서버 포트인데 왜 열어야 하지?”라고 생각하기 쉬운데, 중요한 건 다른 멤버가 그 포트로 이 서버에 들어올 수 있느냐입니다.
즉, 로컬에서 붙는 것과 클러스터 멤버끼리 붙는 건 완전히 다른 문제입니다.
2. 포트 기준 혼선
앱, 백업 설정, 레플리카셋 설정, 실제 컨테이너 포트가 완전히 한 줄로 정렬돼 있지 않았습니다. 어떤 설정은 예전 포트를 보고 있었고, 어떤 설정은 새 포트를 보고 있었습니다. 이런 상황에서는 한쪽은 ECONNREFUSED, 다른 쪽은 RSGhost, 또 다른 쪽은 No primary가 나와도 이상하지 않습니다.
3. 결정적 원인: self-identification 실패
가장 큰 문제는 [서버 B]의 Mongo 컨테이너가 bridge 네트워크 안에서 자기 자신을 내부 주소로 인식하고 있었다는 점이었습니다. 결국 이 멤버가 레플리카셋에서 정상 합류하지 못했고, 선거가 꼬이면서 전체 클러스터가 무너졌습니다.
공식 가이드 관점에서도 설명이 됩니다
MongoDB 공식 문서를 찾아보면 Replica Set 멤버 주소는 모든 멤버가 서로 접근 가능하고, 각 노드가 동일하게 해석할 수 있는 주소여야 한다는 취지의 설명이 반복해서 나옵니다. 표현은 문서마다 조금 다르지만, 실무적으로는 이 말입니다.
내부 컨테이너 주소와 외부 공개 주소를 섞지 말 것
멤버 주소는 실제 통신 가능한 기준으로 통일할 것
레플리카셋은 “살아 있음”보다 “정상 멤버십”이 더 중요하다는 점을 놓치지 말 것
제가 이번에 느낀 건, 공식 문서는 맞는 말을 하고 있는데 운영 현장에서는 그게 아주 사소한 설정 차이로 무너질 수 있다는 점이었습니다. 특히 Docker에서 ports 매핑만 믿고 Replica Set을 운영하면, 시간이 한참 지나 문제없다가도 네트워크 조건이 바뀌는 순간 한꺼번에 드러날 수 있습니다.
업계에서 Mongo 운영해본 분들도 비슷하게 이야기합니다. 단일 컨테이너 Mongo는 bridge로도 괜찮지만, Replica Set은 host 네트워크나 명확한 주소 체계가 더 안전하다는 의견이 많습니다. 저도 이번 일을 겪고 나서는 그 말이 왜 나오는지 정말 체감했습니다.
저는 이렇게 확인했고, 이렇게 풀었습니다
제가 실제로 했던 확인 순서는 이렇습니다.
1. 앱 코드보다 env와 연결 문자열부터 봤습니다
처음엔 코드 문제를 의심할 수도 있는데, 이번엔 아니었습니다. 앱은 환경변수의 MONGODB_URI만 그대로 읽고 있었고, 포트 값이 코드에 박혀 있지도 않았습니다. 그래서 코드 디버깅보다 실행 환경의 URI와 실제 포트 상태 확인이 먼저였습니다.
2. 각 서버에서 실제 리슨 포트를 확인했습니다
이 작업은 꼭 해보셔야 합니다. “설정상 이 포트일 것” 말고, 실제로 어떤 포트에 떠 있는지 봐야 합니다.
이 과정에서 “어떤 서버는 예전 포트 기준으로 말하고 있고, 실제 Mongo는 다른 포트로 떠 있다”는 사실이 드러났습니다.
3. hello, rs.conf(), rs.status()를 따로 봤습니다
이 세 개는 비슷해 보여도 완전히 다릅니다.
이번에도 rs.conf()는 읽히는데 rs.status()는 실패하는 상황이 나왔습니다. 이건 꽤 중요한 단서였습니다.
4. [서버 B]의 컨테이너 자기 인식 주소를 확인했습니다
여기서 결정타가 나왔습니다. 컨테이너가 자기 자신을 외부 호스트 IP가 아니라 내부 가상 IP로 인식하고 있었습니다. 그 순간 “아, 이건 재시작만으로는 안 풀리겠구나” 싶었습니다.
5. 결국 [서버 B] Mongo를 host network로 바꿨습니다
이게 실제 복구 포인트였습니다.
기존에는 bridge 네트워크 + 포트매핑 방식이었고, 수정 후에는 host network 기반으로 실행했습니다. 그러자 그 노드가 드디어 자기 자신을 Replica Set 설정의 멤버로 인식했습니다. 그 뒤에는:
한 노드가 PRIMARY
나머지 두 노드가 SECONDARY
self: true
me: [호스트IP:포트]
이런 정상 상태가 확인됐습니다.
그 순간 진짜 안도감이 들더라고요. 로그를 몇 시간 따라가며 헤맸던 보람이 있었습니다.
초보자라면 이렇게 보시면 됩니다
처음 이런 장애를 겪는 분들은 보통 “몽고가 죽었네”라고 생각합니다. 그런데 실제로는 아래 순서로 보는 게 훨씬 빠릅니다.
Mongo 프로세스가 떠 있는가
해당 포트에 실제로 리슨 중인가
앱/백업/운영 설정이 같은 포트를 보고 있는가
각 멤버가 서로 그 포트로 붙을 수 있는가
그 노드가 자기 자신을 Replica Set 멤버로 인식하는가
개인적으로는 5번을 제일 늦게 본 게 이번 시행착오였습니다. 이제는 반대로 합니다. 로그에 Could not find self, InvalidReplicaSetConfig, no replset config has been received 같은 문구가 보이면, 저는 바로 self-identification 문제를 먼저 의심합니다.
고급 사용자라면 여기까지 보셔야 합니다
운영 경험이 있는 분이라면 이번 케이스에서 체크해야 할 포인트가 더 명확합니다.
Docker bridge와 host network 중 무엇이 Replica Set에 더 적합한가
멤버 주소가 호스트 기준인지, 컨테이너 기준인지 일관성이 있는가
UFW/iptables/NAT 재적용 후 Docker proxy 동작이 바뀌지 않았는가
예전 포트 설정이 앱, 백업, 작업 스케줄러에 잔존해 있지 않은가
장애 후 선거 결과가 기존과 달라졌는가
이번 케이스도 복구 후 원래 프라이머리라고 생각하던 노드가 그대로 프라이머리가 아니었습니다. 이건 이상 현상이 아니라 정상적인 선거 결과였습니다. 운영자는 “원래 누가 PRIMARY였는가”보다 “지금 누가 안정적으로 PRIMARY인가”를 더 중요하게 봐야 합니다.
제가 이번에 확실히 배운 실수 방지 포인트
제가 이렇게 해서 한참 돌아갔습니다.
“컨테이너가 떠 있으니 네트워크는 괜찮겠지”
“SSH 설정 바꿨으니까 UFW만 보면 되겠지”
“일단 재시작하면 붙겠지”
셋 다 절반만 맞는 판단이었습니다.
실제로 중요한 건 이 세 가지였습니다.
개인적으로는 앞으로 Replica Set 환경에서는 무조건 이 체크리스트를 먼저 볼 생각입니다. 특히 Docker 기반 운영이라면 더 그렇습니다.
다만 이 경험이 모든 환경에 그대로 적용되진 않습니다
여기서 한 가지는 꼭 말씀드리고 싶습니다. 이 글은 Docker 기반 MongoDB Replica Set, 다중 서버, 호스트 공개 주소와 컨테이너 내부 주소가 다른 구조에서 겪은 경험을 바탕으로 쓴 내용입니다.
그래서 다음 환경에서는 결론이 조금 달라질 수 있습니다.
Kubernetes 기반 StatefulSet 환경
단일 서버 단일 Mongo 구성
VPN/Overlay 네트워크로 멤버 주소를 통일한 환경
cloud managed MongoDB 서비스
즉, “무조건 host network가 정답이다”까지는 아닙니다. 다만 이번처럼 호스트 주소 기반 Replica Set을 운영하는 Docker 환경에서는 host network가 훨씬 안정적일 수 있다는 정도로 이해하시는 게 맞습니다.
저도 놓친 부분이 있을 수 있습니다. 특히 다른 운영 방식에서는 반대 경험이 있는 분도 분명히 계실 겁니다. 그런 사례는 오히려 더 궁금합니다.
이런 상황이라면 먼저 이걸 의심해보세요
SSH 설정 변경 직후 Mongo 레플리카셋이 이상해졌다
포트포워딩 만진 뒤 앱 접속이 끊겼다
백업은 실패하고, 앱은 ECONNREFUSED를 낸다
PRIMARY가 사라지고 SECONDARY만 남았다
RSGhost, InvalidReplicaSetConfig, Could not find self가 보인다
이런 상황이면 저는 이제 거의 자동으로 이렇게 봅니다.
방화벽 누락 확인
실제 리슨 포트 확인
앱/백업 연결 문자열과 실제 포트 비교
hello, rs.conf(), rs.status() 비교
컨테이너 self IP 확인
필요하면 bridge 대신 host network 검토
업계에서 잘 안 알려진 팁 하나만 덧붙이면, Replica Set 장애는 “설정 파일이 맞는가”보다 “그 설정이 런타임에서 동일하게 해석되는가”가 더 중요합니다. 파일만 봐서는 정상처럼 보여도, 런타임 네트워크가 다르면 그대로 무너집니다.
저는 앞으로도 이런 운영 장애 사례를 겪으면, 단순히 “고쳤다” 수준에서 끝내지 않고 왜 그런지까지 계속 정리해두려고 합니다. 정보는 자꾸 바뀌고, Docker나 Mongo 운영 패턴도 계속 달라지니까요. 혹시 비슷한 장애를 겪고 계시거나, 반대로 다른 방식으로 더 깔끔하게 복구한 경험이 있으시면 공유해 주세요. 그런 사례가 쌓일수록 다음 사람은 훨씬 덜 헤맬 수 있으니까요.