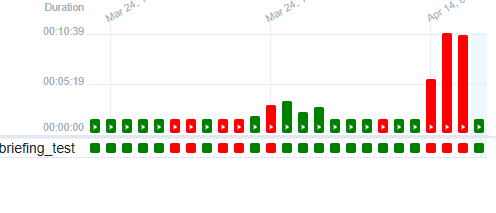
Airflow에서 유튜브 브리핑 DAG가 갑자기 10분씩 멈추더니 결국 timeout으로 죽었다. 처음엔 vLLM 서버가 맛간 줄 알았는데 로그를 까보니까 그건 또 아니더라. 결국 입력이 너무 컸고, 추론 끄는 옵션도 안 넣고 돌리고 있었다.
왜 갑자기 이렇게 느려졌을까?
처음 본 에러는 이런 느낌이었다.
[08:00:06] Retrieving connection 'mongo_default'
[08:05:06] briefing llm provider failed: provider=vllm, error=timed out
[08:05:06] briefing llm fallback start: provider=openai
[08:06:36] briefing llm provider failed: provider=openai, error=The read operation timed out
[08:06:36] briefing llm fallback start: provider=gemini
[08:08:07] RuntimeError: All briefing LLM providers failed
처음 판단은 단순했다.
vLLM 죽음
외부 API도 같이 불안정
오늘따라 뉴스가 좀 많았나 봄
근데 DB를 다시 보니까 좀 많다 수준이 아니었다.
raw 입력 72개
중복 정리 후 37개
실제 브리핑 입력도 37개
prompt 길이 약 28,840자
최근 배치랑 비교하면 더 티가 났다.
즉 평소보다 1.8배쯤 되는 묶음이었다. 여기서 이미 냄새가 났다. 아 그냥 timeout 숫자만 올릴 문제가 아니구나 싶더라.
뭘 잘못 보고 있었나?
제일 먼저 착각한 건 이거였다.
근데 컨테이너 안에서 직접 확인해보면 소켓 연결도 되고 헬스체크도 잘 된다. vLLM 로그를 보면 더 명확했다.
Running: 2 reqs, Waiting: 0 reqs
Avg generation throughput: 79~84 tokens/s
GPU KV cache usage: 5~8%
이 로그는 서버가 멈춘 상태가 아니다.
요청 2개를 실제로 계속 생성 중이었다
Waiting 0 이라 큐 적체도 아니었다
GPU도 빵빵하게 찬 상태가 아니었다
즉 서버 장애가 아니라 그냥 한 요청이 너무 오래 생성되고 있었던 거였다. 여기서 내가 한 번 틀렸다. 서버 탓을 먼저 했다가 다시 돌아왔다.
뭘 먼저 해봤나?
처음엔 제일 단순하게 timeout부터 올렸다.
OPENAI_TIMEOUT_SECONDS = 180
GEMINI_TIMEOUT_SECONDS = 180
VLLM_TIMEOUT_SECONDS = 600
이건 맞는 대응이긴 한데, 이것만으로는 안 끝났다.
예전 300초 timeout은 넘겼는데, 이번엔 600초를 꽉 채우고 또 죽더라. 그때 진짜 허무했다. 10분 줬는데도 못 끝내네 싶어서.
그다음엔 입력을 나눴다.
대충 이런 식이다.
def _chunk_videos(videos, chunk_size=30):
    return [
        videos[i:i + chunk_size]
        for i in range(0, len(videos), chunk_size)
    ]
with ThreadPoolExecutor(max_workers=2) as executor:
    results = list(executor.map(run_chunk, chunks))
이걸 넣고 나서 로그가 이렇게 바뀌었다.
briefing vllm chunk mode start: source_count=35, chunk_size=30, chunk_count=2, workers=2
근데 이것도 처음엔 600초를 다 써버렸다.
여기서 확신했다. 이건 그냥 입력이 큰 게 아니라, 모델이 너무 오래 생각하고 있다.
왜 추론 끄는 설정을 늦게 봤을까?
이게 제일 아쉬운 부분인데, 이미 다른 코드엔 답이 있었다.
Next 쪽 유튜브 요약 코드에는 이런 설정이 있었다.
{
  "reasoning_effort": "low",
  "include_reasoning": false,
  "chat_template_kwargs": {
    "enable_thinking": false
  }
}
근데 Airflow DAG 쪽 vLLM 요청 body는 이랬다.
body = {
    "model": model,
    "messages": [...],
    "temperature": 0.1,
}
끝.
추론 끄는 설정이 아예 없었다. 문서 안 읽고 삽질한 거였다. 진짜.
그래서 Airflow 쪽도 이렇게 맞췄다.
body = {
    "model": model,
    "reasoning_effort": "low",
    "include_reasoning": False,
    "chat_template_kwargs": {
        "enable_thinking": False,
    },
    "messages": [
        {
            "role": "system",
            "content": f"{system_prompt}\n\nReasoning: low",
        },
        {
            "role": "user",
            "content": prompt,
        }
    ],
    "temperature": 0.1,
}
결국 어디서 풀렸나?
결국 먹힌 조합은 이거였다.
그 뒤 저장된 결과 문서를 보면 이렇게 나온다.
즉 안 되던 게 되긴 했다.
생각보다 큰 건 timeout 숫자보다도 thinking off 였다.
다시 같은 일 나면 뭘 먼저 볼까?
vLLM이 timeout 났다고 바로 서버 장애로 보면 안 된다. 컨테이너 로그에서 Running reqs, generation throughput 먼저 본다.
입력 개수만 보지 말고 실제 prompt 길이도 같이 본다. 이번엔 37개보다 2.9만자가 더 치명적이었다.
chunking만 넣으면 끝날 줄 알았는데 안 끝난다. 모델이 오래 생각하면 chunk 두 개가 같이 오래 생각한다.
다른 서비스에서 이미 쓰는 설정이 있으면 먼저 가져와 본다. 추론 끄는 옵션이 이미 있었는데 괜히 한 바퀴 돌았다.
timeout은 응급처치다. 근본은 입력 줄이기, chunking, thinking off 쪽이다.
다음엔 max_tokens 상한도 같이 걸 생각이다. 아직 안 해봤다. 근데 필요해 보인다.