처음엔 nginx.conf에 upstream mongodb가 있길래, 아 이게 몽고 클러스터였나 싶었다.
레플리카셋 설정한뒤 거의 1년이 지난 상황이라 기억이 잘 안나는 상태였다.
근데 까보니까 그건 안 쓰는 설정이었고, 실제로 살아 있는 건 MongoDB replica set 쪽이었다. 여기서 한 번 잘못 봤고, 그 뒤로는 꼬일 만한 걸 거의 다 밟았다.
왜 nginx 설정부터 잘못 봤을까?
눈에 제일 먼저 들어온 게 이거였다.
upstream mongodb {
server 127.0.0.1:2409;
server 127.0.0.1:2410;
}
처음엔 이걸 보고 이렇게 생각했다.
서버 두 개가 묶여 있음
이름도 mongodb
그럼 클러스터 아님?
근데 실제로는 아니었다.
Nginx upstream은 그냥 프록시 대상 묶음이다
MongoDB replica set은 DB 자체 클러스터다
심지어 이 upstream mongodb는 실제로 참조도 안 되고 있었다
결국 몽고 클러스터를 봐야 하는데, Nginx만 보고 헷갈린 거였다.
이게 왜 있던거더라...기억이 나질 않아서 골치아팠다.
왜 노드 하나만 더 붙이면 끝날 줄 알았을까?
기존 구조가 대충 이런 느낌이었다.
A서버에 몽고 2개
B서버에 몽고 1개
여기에 C서버를 하나 더 붙이려는 상황
처음 생각은 단순했다.
그냥 하나 더 붙이면 더 튼튼해지겠지
voting 멤버도 많아지니까 더 안전하겠지
근데 계산을 해보면 그렇지 않다.
3 voting이면 과반 2
4 voting이면 과반 3
문제는 표 숫자보다 호스트 분산이었다.
A서버에 표가 2개 몰려 있으면
A서버가 통째로 죽는 순간 과반이 깨진다
그래서 그냥 4번째 voter를 추가하는 건 애매했다.
내가 원한 건 노드 수 증가가 아니라 호스트 분산이었다.
결국 방향을 이렇게 바꿨다.
즉 추가가 아니라 사실상 재배치였다.
왜 새 노드는 계속 죽었을까?
여기서 제일 많이 삽질했다.
처음엔 docker-compose만 올리면 될 줄 알았다. 안 된다.
새 노드는 계속 재시작했다.
실제로 본 로그는 이런 쪽이었다.
permissions on /data/mongodb.key are too open
Unable to acquire security key[s]
그리고 그 다음엔 또 이렇게 바뀌었다.
error opening file: /data/mongodb.key: bad file
처음엔 mongod가 이상한 줄 알았는데 아니었다.
문제는 거의 전부 keyfile 쪽이었다.
내가 밟은 실수는 이랬다.
keyfile이 아예 없는 상태로 컨테이너 먼저 띄움
bind mount source가 없어서 파일이 아니라 디렉터리로 꼬임
권한을 400으로 줄였는데 소유자가 root:root라 컨테이너 유저가 못 읽음
심지어 기존 레플리카셋과 같은 keyfile이어야 하는데 그걸 뒤늦게 다시 확인함
해결은 의외로 단순했다.
이거였다.
mkdir -p ./docker-volumes/keyfile
sudo install -m 400 /dev/null ./docker-volumes/keyfile/mongodb.key
sudo chown 999:999 ./docker-volumes/keyfile/mongodb.key
sudo chmod 400 ./docker-volumes/keyfile/mongodb.key
진짜 허무한데, 대부분은 여기서 해결됐다.
왜 버전도 먼저 맞춰야 했을까?
이것도 뒤늦게 보였다.
한 멤버는 이미 8.2.2였고, 다른 멤버는 8.0.x였다.
새 노드만 8.2.2로 붙이면 그냥 더 애매해진다.
그래서 먼저 한 건 이미지 버전 고정이었다.
image: mongo:8.2.2
이걸 기존 멤버 compose에도 맞췄다.
latest 두고 운영하는 건 진짜 계속 발목 잡는다. 당장은 편한데 나중에 고생한다더라.
새 노드는 어떻게 붙였나?
한 번에 voting member로 안 붙였다. 그랬으면 더 불안했을 거다.
순서는 이랬다.
새 노드 기동
PRIMARY에서 non-voting secondary로 추가
SECONDARY 될 때까지 대기
기존 secondary 제거
새 노드에 표 부여
priority: 0 유지
명령은 이런 식이었다.
rs.add({
host: "[내부경로]:27017",
priority: 0,
votes: 0
})
동기화 끝나고 나서는:
rs.remove("[내부경로]:2410")
그리고 마지막에:
cfg = rs.conf()
i = cfg.members.findIndex(m => m.host === "[내부경로]:27017")
cfg.members[i].votes = 1
cfg.members[i].priority = 0
rs.reconfig(cfg)
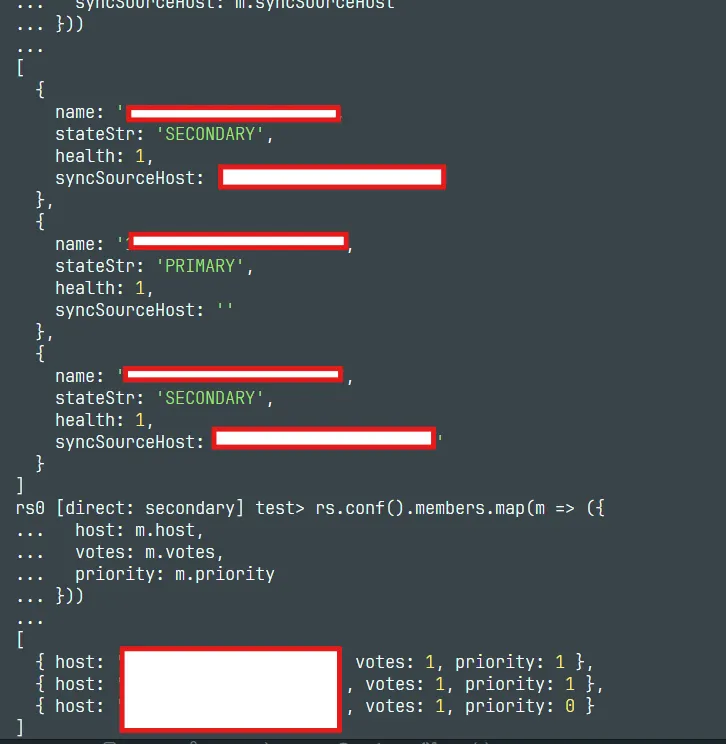
최종 상태는 이런 그림이 됐다.
A서버 PRIMARY
B서버 SECONDARY
C서버 SECONDARY
세 멤버 모두 votes: 1
C서버만 priority: 0
이 구조가 내가 처음 원하던 거였다.
노드 수만 늘린 게 아니라, 호스트 분산이 된 구조.
왜 앱 연결 문자열도 다시 봐야 했을까?
이것도 은근 함정이었다.
앱 쪽엔 이런 식의 URI가 남아 있었다.
MONGODB_URI="mongodb://[개인정보]:[개인정보]@[내부경로]:2409,[내부경로]:2410,[내부경로]:2411/nuuthang?replicaSet=rs0&authSource=admin"
문제는 레플리카셋 재배치가 끝난 뒤엔 이 주소들이 이미 낡았다는 점이다.
여기서 헷갈렸던 게 또 하나 있다.
이걸 몰라서 아니, 정확히는 알고도 설마 하고 넘겼다가 다시 확인했다.
하나만 넣어도 붙긴 붙는다. 근데 stale 주소 섞여 있으면 나중에 또 사람 피곤해진다.
다시 하면 뭘 먼저 볼까?
Nginx upstream과 MongoDB replica set를 같은 걸로 보면 안 된다. 이름 같다고 같은 게 아니다.
노드 수보다 호스트 분산을 먼저 본다. 2-1-1 같은 구조는 숫자만 늘려도 안 예뻐진다.
새 멤버는 무조건 같은 keyfile을 써야 한다. 여기서 많이 죽는다.
keyfile은 파일이 맞는지, 권한이 400인지, 소유자가 컨테이너 유저인지 바로 본다.
image: mongo:latest는 안 쓴다. 버전 정렬부터 하고 붙인다.
새 노드는 처음부터 votes: 1로 넣지 않는다. SECONDARY 확인하고 표를 넘긴다.
이번 건은 결국 몽고가 어려웠다기보다,
내가 Nginx, Docker bind mount, keyfile, replica set quorum을 한 번에 섞어서 생각한 게 문제였다.
하나씩 끊어서 봤으면 훨씬 빨리 끝났을텐데, 또 그렇게는 안 되더라.
어찌됐든 2호스트에 몰려 있던 구성을 3호스트로 다시 분산해놨다.
귀찮아서 계속 미루던 작업이었는데, 이번에 아예 정리했다.
사실 노드를 더 늘릴 수도 있긴 한데 굳이 여기서 더 벌릴 필요는 없어 보였다.
대신 새로 붙인 노드는 priority: 0으로 둬서 프라이머리 승격은 막았다.
투표권은 줬지만, 하드웨어가 100Mbps 환경이라 혹시 모를 상황에서 프라이머리까지 맡기는 건 부담스러웠다.